 STRONG TOWER APPS™
Proyecto Tuwr-Sentinel (Demo - Edge AI)
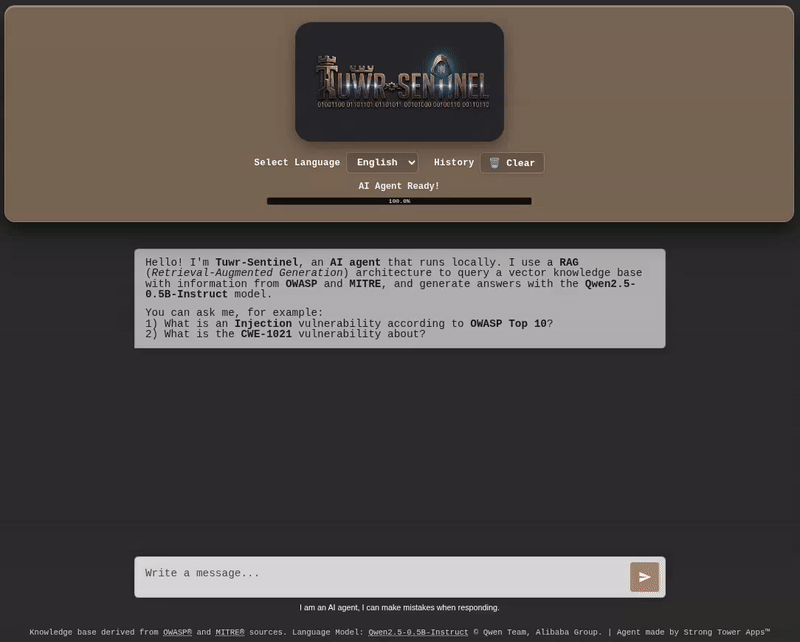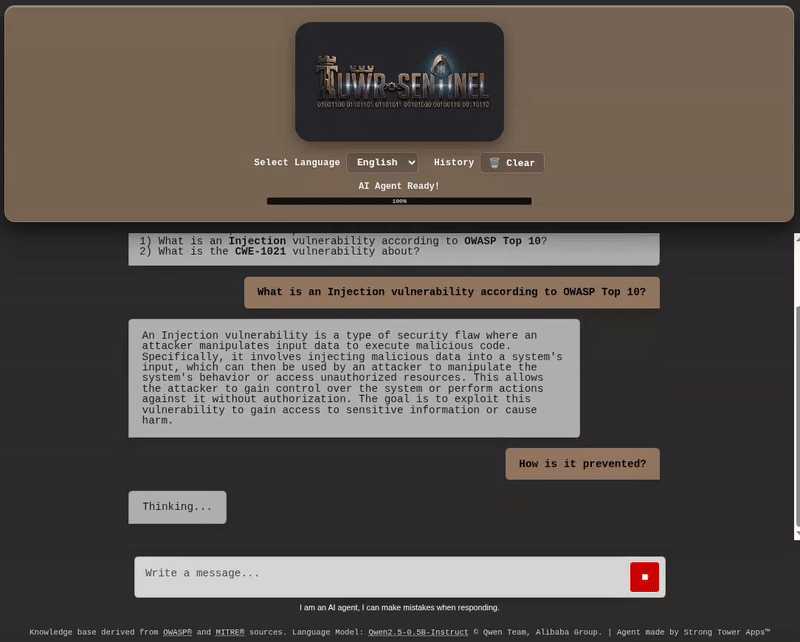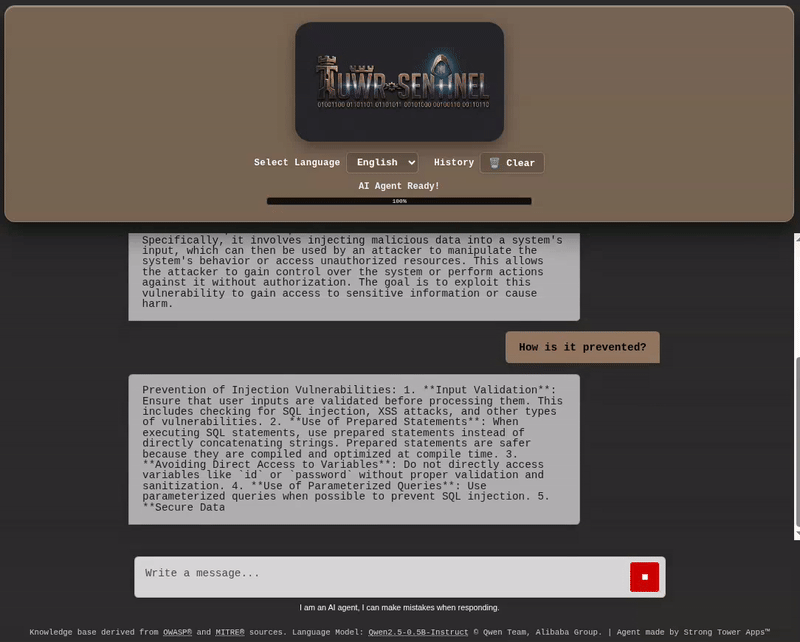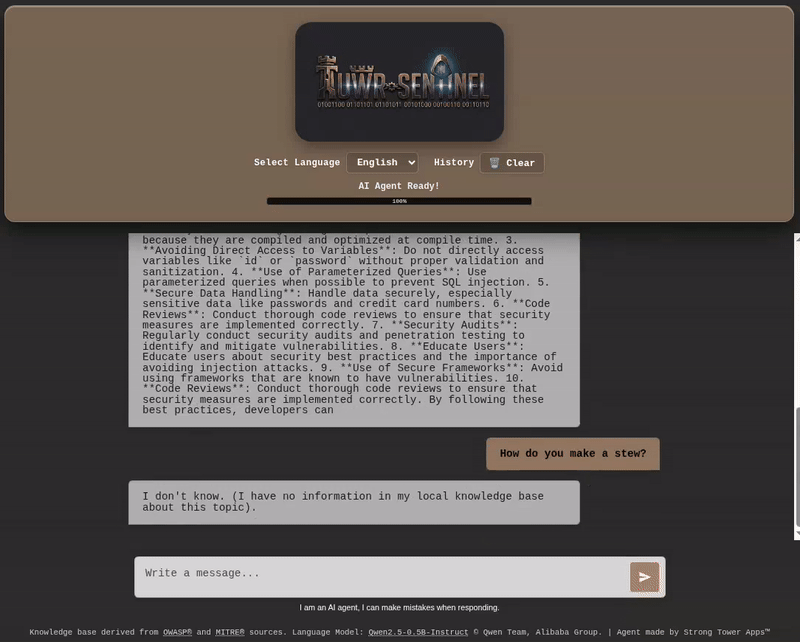
Tuwr-Sentinel es un Agente de Inteligencia Artificial (Edge AI) diseñado para asistir y responder consultas sobre ciberseguridad, con énfasis en los marcos de trabajo de OWASP y MITRE.
Esta versión es una demostración técnica interactiva que opera bajo una arquitectura RAG (Retrieval-Augmented Generation), ejecutándose por completo de forma local. Dado que utiliza modelos de lenguaje pequeños para poder correr en los dispositivos, las respuestas pueden presentar cierta inestabilidad o "alucinaciones". Por lo tanto, debe considerarse estrictamente como una versión de prueba para fines de laboratorio y experimentación.
🚀 Características Principales
- RAG Local: La base vectorial, la búsqueda semántica y la inferencia del modelo de lenguaje (LLM) se realizan localmente en el cliente sin enviar datos a servidores externos.
- Especializado en OWASP & MITRE: Consulta de manera ágil los conceptos, vulnerabilidades comunes (CWE) y sus respectivas mitigaciones.
- Multilingüe: Soporte completo para consultas y bases de conocimiento tanto en español como en inglés.
- Ejecución Adaptativa: Aprovecha tecnologías como WebGPU y WASM (WebAssembly) a través del hardware local.
🛠️ Tecnologías Utilizadas
- Motor de Inferencia: ONNX Runtime Web.
- Modelo Base Adaptativo:
- 💻 Escritorio:
Qwen2.5-0.5B-Instruct(~350MB, cuantizado en Q4) para obtener la máxima precisión de respuesta. - 📱 Móviles / Tablets (Solo Android): Fallback automático a
SmolLM2-135M-Instruct(~70MB, cuantizado en Q4) para garantizar la ejecución sin crashes en dispositivos Android de gama media/baja. Restricción de Apple: Los dispositivos iOS y iPadOS están bloqueados intencionalmente ya que límites muy estrictos de memoria WebAssembly que hacen colapsar al navegador. Nota: Debido a su tamaño ultra-reducido, la calidad de las respuestas en móviles Android es inferior a la de escritorio.
- 💻 Escritorio:
- Búsqueda Vectorial Inteligente: Motor híbrido (Orama) que balancea TF-IDF y similitud de embeddings, con detección dinámica de Follow-Up (preguntas de seguimiento) para enriquecer el contexto.
- Interfaz: Aplicación Web Reactiva (HTML5, Vanilla CSS, JS moderno).
🎥 Demostración en Acción
Puedes observar la funcionalidad del agente en la siguiente grabación:
⚠️ Nota Importante sobre Producción y Arquitectura a Escala
Este proyecto es una demostración conceptual (Proof of Concept) sobre Agentes de IA Edge (Edge AI Agents), que tiene como fin ilustrar la interacción en tiempo real de componentes complejos (búsqueda híbrida RAG, análisis de intenciones y generación LLM) corriendo directamente en un cliente estático local.
No se recomienda esta arquitectura estrictamente local para proyectos empresariales o en producción masiva debido a las limitaciones inherentes del cliente (tiempo de carga inicial al descargar el modelo, uso intensivo de la RAM, variabilidad del procesador móvil del usuario y dificultad para sincronizar la base de vectores en tiempo real).
🏛️ Arquitectura de Producción Recomendada (A Escala)
Para un entorno productivo robusto, seguro y escalable, la arquitectura recomendada es Cloud-Native / Híbrida:
- Cliente Liviano (SPA/SSR): Una interfaz frontend construida en frameworks como React o Next.js, que no realiza tareas de inferencia ni almacena datos locales. Consume APIs mediante streaming de texto (SSE) para brindar una experiencia instantánea al usuario independientemente de su dispositivo.
- Backend de Orquestación (API Gateway): Un servicio backend seguro (FastAPI, NestJS o Node.js con LangChain/LlamaIndex) que valida los prompts del usuario, gestiona políticas de seguridad y administra la sesión de chat.
- Base de Datos Vectorial Centralizada: Un motor de base de datos vectorial gestionado (como Qdrant, Pinecone, Milvus o Postgres con pgvector) que almacena millones de documentos de seguridad indexados, permitiendo actualizaciones en tiempo real y búsquedas en milisegundos desde el backend.
- Inferencia del LLM Escalable:
- Servicio Gestionado: Uso de APIs empresariales de alto rendimiento (OpenAI, Claude, Gemini) con protección de datos comerciales.
- Infraestructura Privada: Despliegue de modelos de código abierto a gran escala (como Llama 3 o Qwen 2.5 de parámetros completos) en servidores de GPU propios o dedicados a través de motores de inferencia escalables como vLLM, TGI (Text Generation Inference) o Ollama.